Server, kterému dochází operační paměť, obvykle dostane drahý upgrade, nebo začne přesouvat data do pomalejší vrstvy. Návrh CRAM pro Linux nabízí třetí cestu: komprimovaná paměť by se chovala jako přímo adresovatelná paměťová vrstva, nikoli jako odkládací zařízení. V testu zaměřeném pouze na čtení dosáhla přibližně 489 milionů operací za sekundu, zatímco ZRAM zvládla zhruba 1,1 milionu. Odtud pochází titulkové zrychlení až 452krát — číslo působivé jako tramvaj svištící prázdnou noční ulicí, ale platné jen pro konkrétní zátěž.
Za návrhem stojí inženýr společnosti Meta Gregory Price. CRAM představil na konferenci Linux Plumbers v Praze v říjnu 2026 jako technologii, která stále čeká na posouzení pro začlenění do jádra Linuxu; nejde tedy o funkci připravenou k instalaci. Pro správce serverů, kteří počítají každý drahý gigabajt DRAM, je přesto zajímavá otázka nasnadě: dokáže komprese dat nabídnout víc než jen úsporu místa? Odpověď závisí na tom, zda systém hlavně čte, nebo také často zapisuje.
CRAM v Linuxu: komprimovaná paměť jako nová vrstva
ZRAM a zswap pracují kolem swapovací vrstvy. Když program potřebuje data uložená v této komprimované oblasti, cesta k nim může zahrnovat obsluhu stránkové chyby a softwarovou dekompresi, což přidává práci procesoru i čas.
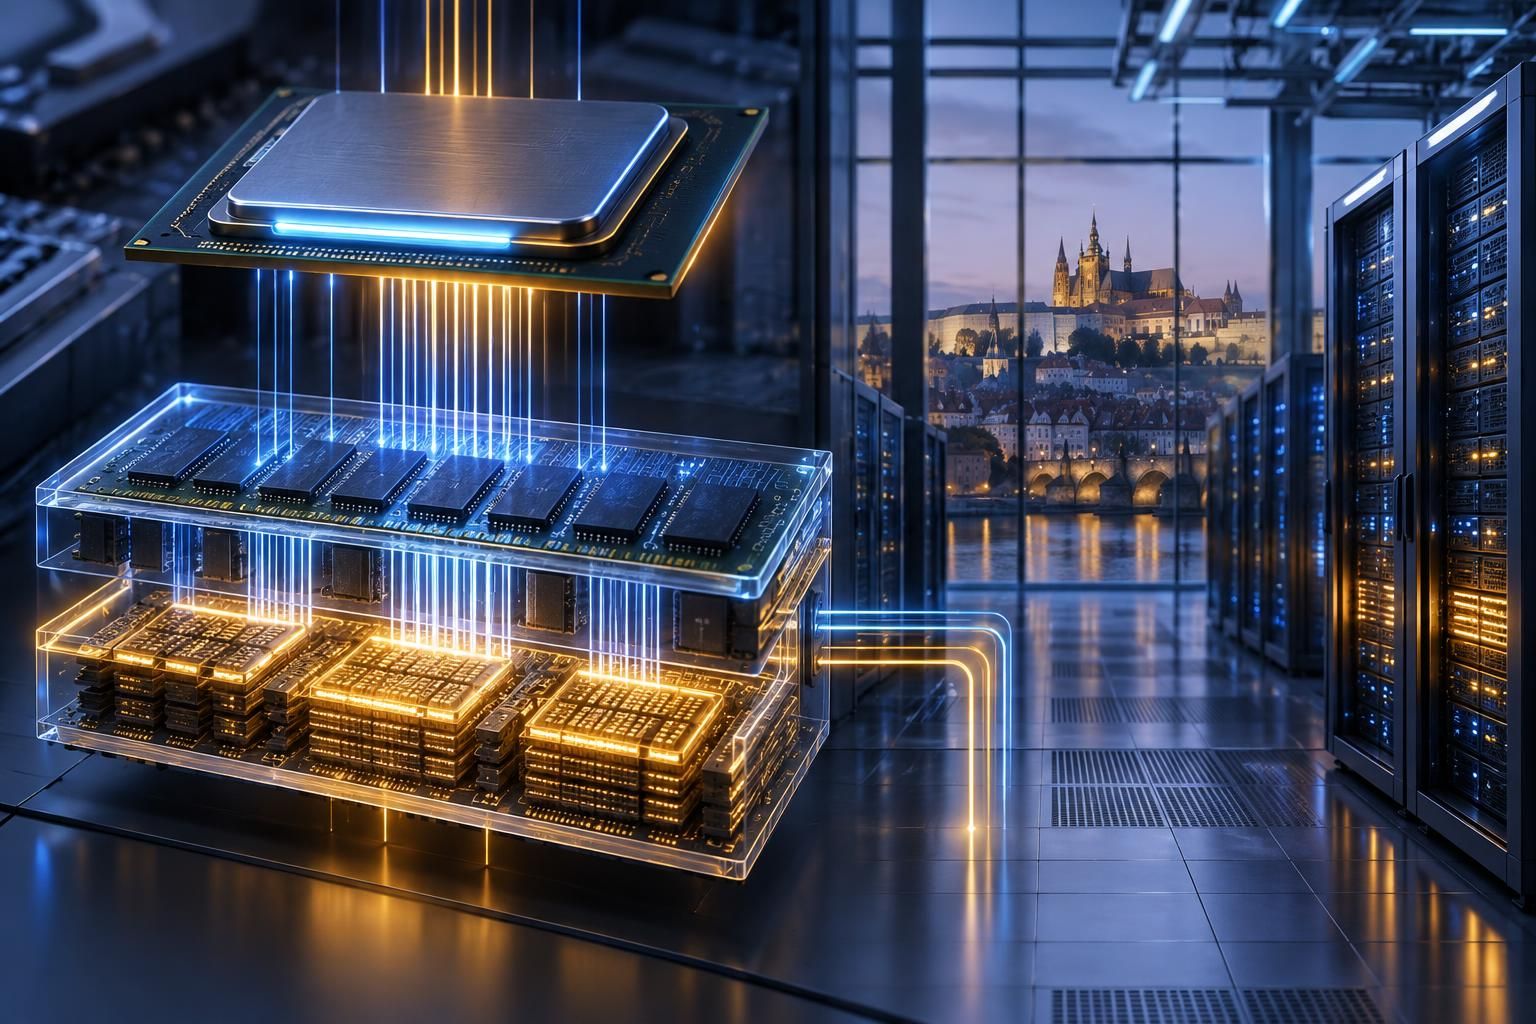
CRAM míří jinam. Počítá se specializovaným hardwarem, který data komprimuje, ale zachová přístup po bajtech nebo cache linech. Stránky tak mohou zůstat namapované v tabulkách stránek; při čtení je rozbalí hardware a Linux nemusí nejprve vyvolat stránkovou chybu a přesunout obsah zpět do běžné DRAM.
V praxi by šlo o pomalejší paměťovou úroveň, podobnější NUMA uzlu než disku. Návrh využívá existující nástroje jádra pro tiering, uvolňování paměti, přesun stránek i NUMA alokaci. Zjednodušeně: CRAM mění pohled na komprimovanou paměť z odkladiště na další patro paměťového domu.
Proč může být přístup k datům tak rychlý
Rozdíl nevytváří jen rychlost komprese, ale především způsob, jakým se k uloženým datům přistupuje. Pokud hardware obslouží čtení bez návratu stránky do DRAM, odpadá část režie typické pro swapovací cestu a výsledné zrychlení paměti může být výrazné.
V některých zveřejněných testech se čtecí výkon CRAM pohyboval na úrovni přibližně 98 až 99 procent běžné DRAM. Tato měření však používala DRAM k oddělení softwarové režie od zbytku systému; nejsou tedy definitivním obrazem výkonu skutečného komprimujícího hardwaru.
Výkon systému: proč údaj 452× neplatí pro každou zátěž
Hlavní číslo pochází z benchmarku pouze pro čtení: CRAM zvládla asi 489 milionů operací za sekundu proti přibližně 1,1 milionu u ZRAM. Jde o násobné zrychlení v přesně vymezeném testu, nikoli o slib, že každá linuxová aplikace poběží 452krát rychleji.
| Typ zátěže | Uváděný náskok CRAM proti ZRAM | Co výsledek znamená |
|---|---|---|
| Pouze čtení | Přibližně 452× | Výsledek specifického benchmarku; nelze jej zobecnit na všechny aplikace. |
| Nízký podíl zápisů | Přibližně 37× | Výhoda zůstává vysoká, ale zápis už mění chování systému. |
| 20 % zápisů | Přibližně 5,4× | Náskok se zmenšuje a test zahrnoval výrazné prodlevy při zaplnění paměti. |
Rozdíl je důležitý pro každodenní provoz. Databázový server s převahou čtení může z nové vrstvy těžit jinak než služba, která neustále mění pracovní data; jakmile se zvýší podíl zápisů, výkonová výhoda rychle klesá.
- Čtecí zátěž: nejpříznivější scénář a zdroj rekordního výsledku.
- Občasné zápisy: CRAM si podle uváděných testů zachovává citelný náskok, přesto už nejde o 452násobek.
- Časté zápisy a plná paměť: stránka se při zápisu přesouvá zpět do DRAM a systém může čekat na uvolnění kapacity.
Provozovatel malé cloudové farmy by tak neměl sledovat jen počet operací za sekundu. Rozhodující je skladba úloh a okamžiky, kdy se paměť zaplní — právě tam se laboratorní rekord potkává s méně pohodlnou realitou serverové směny.
Správa paměti v CRAM: zápisy, kapacita a „Chicken Bit“
Stránky umístěné v CRAM jsou podle návrhu považovány za pouze pro čtení. Když se je program pokusí změnit, vyvolá se chyba a stránka se nejprve přesune zpět do běžné DRAM. Tento postup chrání správnost dat, ale vysvětluje, proč zápisové úlohy snižují náskok technologie.
Další komplikací je proměnlivý kompresní poměr. Jedna aplikace může data stlačit výrazně, jiná jen nepatrně, takže operační systém nemůže předpokládat, že určitá velikost virtuálně přidělené paměti vždy zabere stejné množství fyzické kapacity. Návrh proto obsahuje pojistku označovanou jako „Chicken Bit“: Linux má přestat přidělovat další komprimovanou kapacitu, pokud zařízení nestíhá obsluhovat zápisy.
Jde o užitečnou brzdu, nikoli o úplné vyřešení kapacitního účetnictví. Při testu s 20 procenty zápisů se objevily také výrazné prodlevy v obdobích, kdy byla paměť téměř plná — připomínka, že ani chytrá optimalizace Linuxu neodstraní tlak na nedostatečnou kapacitu.
Co brání nasazení na běžném počítači
Mechanismy správy paměti, na které CRAM spoléhá, už v Linuxu existují. Chybí však vyřešené začlenění návrhu do jádra i dostupný kompatibilní hardware; pro běžné notebooky a stolní počítače zatím nejde o praktickou volbu.
Jednou z možných cest jsou paměťové expandéry CXL s kompresí přímo v zařízení. Pokud se takový hardware prosadí, mohl by CRAM rozšířit paměťové možnosti zejména v serverech a cloudové infrastruktuře, kde je přidání DRAM nákladné. Další krok proto není jen softwarový: závisí také na hardwaru a na tom, zda návrh projde kontrolou vývojářů jádra.